Lëtzebuergesch Clavier · Labs
Transcrire du luxembourgeois, d'un fichier ou en direct 🎧
Deux façons de mettre par écrit ce qui se dit en luxembourgeois. Un fichier : déposez une réunion, une interview, un podcast ; le service LuxASR l'écrit et sépare les voix, chaque réplique rattachée à son locuteur et à l'instant où elle est dite. En direct : le texte s'écrit pendant qu'on parle autour du micro.
🎓 La transcription et la séparation des voix sont le travail de LuxASR, le service de reconnaissance de la parole luxembourgeoise de l'Université du Luxembourg. Cette page envoie le son et met en forme ce qui revient ; elle le fait avec leur accord, dans le cadre exploratoire de Labs. Leur service est partagé : gardez-le pour de vrais besoins et des essais raisonnables. Merci à leur équipe.
Transcrire
🔊 Le son part à l'Université du Luxembourg, fichier ou micro, et elle le transcrit sur ses serveurs : c'est leur politique de protection des données qui s'applique. Le traitement a lieu sur un serveur de l'Université, au Luxembourg ; l'audio y est effacé dès la fin du traitement, le texte dès qu'il est lu, et rien ne sert à entraîner leurs modèles. Ce site ne reçoit et ne garde rien : la page tourne dans votre navigateur.
Ne transcrivez que ce que vous avez le droit d'enregistrer, avec l'accord des personnes qu'on y entend.
Lors de votre dernier essai, ce navigateur n'a pas pu lire la réponse du service (voir plus bas). Vous pouvez réessayer, le service l'a peut-être corrigé, ou passer par luxasr.uni.lu et ouvrir le résultat ici.
- Envoi
- File d'attente
- Transcription
Vous avez déjà un résultat LuxASR ?
Ouvrez ici un fichier produit par LuxASR (JSON, SRT, VTT ou texte), par exemple depuis le formulaire de luxasr.uni.lu : vous retrouvez la lecture par locuteur, le renommage et les exports. Le fichier reste dans votre navigateur. Choisissez aussi l'enregistrement ci-dessus pour l'écouter en lisant.
Le texte s'écrira ici pendant qu'on parle. La fin d'une phrase, soulignée, peut encore changer.
Copie des consignes et la transcription, puis ouvre Claude dans un nouvel onglet : collez-y le tout pour obtenir le compte rendu (participants, résumé, décisions, actions). Le texte, pas l'audio, part alors chez Anthropic, sous votre propre compte Claude.
En direct, les voix ne sont pas séparées : pour savoir qui a dit quoi, enregistrez, puis passez par « Un fichier ». Une heure d'écoute au plus ; gardez la page ouverte et l'écran allumé.
La transcription
Une seule voix a été détectée. Si l'enregistrement en contient plusieurs, indiquez leur nombre dans « Nombre de voix » et relancez : la détection automatique confond souvent des voix proches et des répliques courtes. Vous pouvez aussi rattacher vous-même les paragraphes en lisant.
Le résultat est arrivé, mais sous une forme que cette page ne sait pas encore lire. Le voici tel quel ; il reste téléchargeable avec « Réponse brute ».
Copie des consignes et la transcription, puis ouvre Claude dans un nouvel onglet : collez-y le tout pour obtenir le compte rendu (participants, résumé, décisions, actions). Le texte, pas l'audio, part alors chez Anthropic, sous votre propre compte Claude.
Transcription automatique par LuxASR, Université du Luxembourg. Elle se trompe sur une part des mots : relisez-la avant de la diffuser.
Bon à savoir
- Les voix sont séparées, pas reconnues. Le service regroupe ce qui sonne comme une même voix, sans savoir qui parle : renommez les locuteurs une fois le texte affiché, les exports suivent.
- Les répliques très courtes, les voix proches et celles qui se chevauchent sont mal séparées, c'est une limite connue de la méthode. Indiquer le nombre de voix aide nettement, au prix parfois d'un peu de justesse du texte ; une pièce calme et un micro proche de chacun aident aussi.
- Le service est fait pour le luxembourgeois. Un passage dans une autre langue peut revenir mal transcrit.
- L'attente dépend surtout de la file : le service traite les fichiers de tout le monde, les uns après les autres. Gardez la page ouverte jusqu'au résultat.
- En direct, le texte arrive au fil de la parole, une seconde environ après les mots, et se corrige jusqu'à la fin de la phrase. C'est le même service que la dictée du clavier, sans séparation des voix. Sa traduction en français, si vous la demandez, est aussi la leur : elle suit phrase par phrase, et se trompe comme toute traduction automatique.
- Une vidéo marche aussi : seule sa piste son est transcrite, mais c'est le fichier entier qui part. Pour un long film, extraire le son d'abord accélère l'envoi.
En test : l'application Lëtzebuergesch Réunion 📱
Pour les réunions en luxembourgeois, nous essayons une application Android qui reprend cette page et va un pas plus loin. Elle s'adresse à la personne qui assiste à la réunion et doit en faire le compte rendu, par exemple une secrétaire de direction.
- Pendant la réunion, ce qui se dit s'affiche en sous-titres : chaque phrase en grand, en luxembourgeois, avec sa traduction en français dessous, les deux ensemble. Un bandeau « En direct » montre les mots au moment où ils sont dits. Le texte complet reste à portée d'un bouton.
- À la fin, un seul bouton. L'enregistrement complet part chez LuxASR, qui sépare les locuteurs, puis le compte rendu se prépare : résumé, points discutés, décisions, actions à mener, et les passages à vérifier, avec leur minutage.
- Ensuite, on relit, on corrige et on envoie le compte rendu par e-mail, sans quitter l'application.
- Un enregistrement déjà fait, audio ou vidéo, se transcrit de la même façon.
L'installer sur un téléphone ou une tablette Android
📲 Télécharger l'application (Android 8 ou plus)
- Ouvrez le fichier téléchargé. Si Android le demande, autorisez l'installation depuis votre navigateur.
- Au premier lancement, l'application demande l'accès au micro et aux notifications.
- Pour le compte rendu automatique, la personne qui installe l'application colle une clé d'API Claude ou Mistral dans ses réglages d'installation (appui long sur le petit texte gris en bas de l'accueil). Sans clé, tout le reste fonctionne, et le compte rendu se fait dans l'application Claude.
C'est une préversion de test, mise à jour à chaque amélioration : pour la mettre à jour, retéléchargez-la ici. Dites-nous ce que vous en pensez avec le formulaire en bas de page.
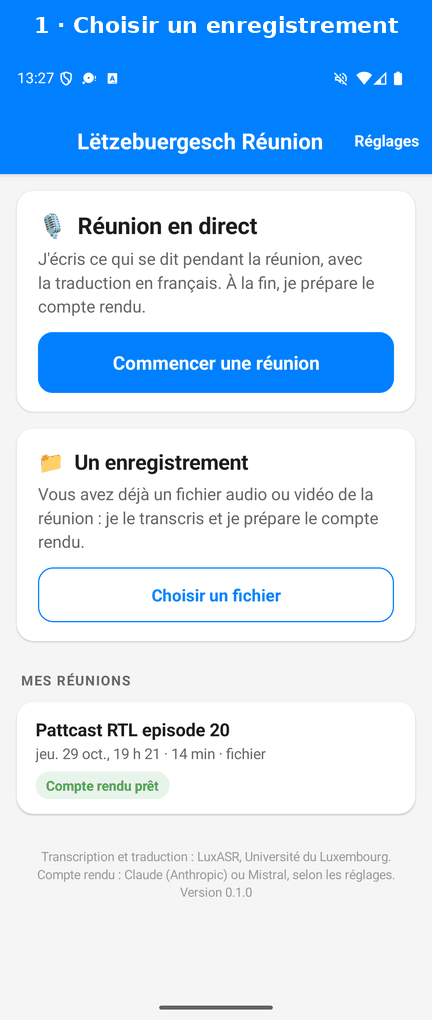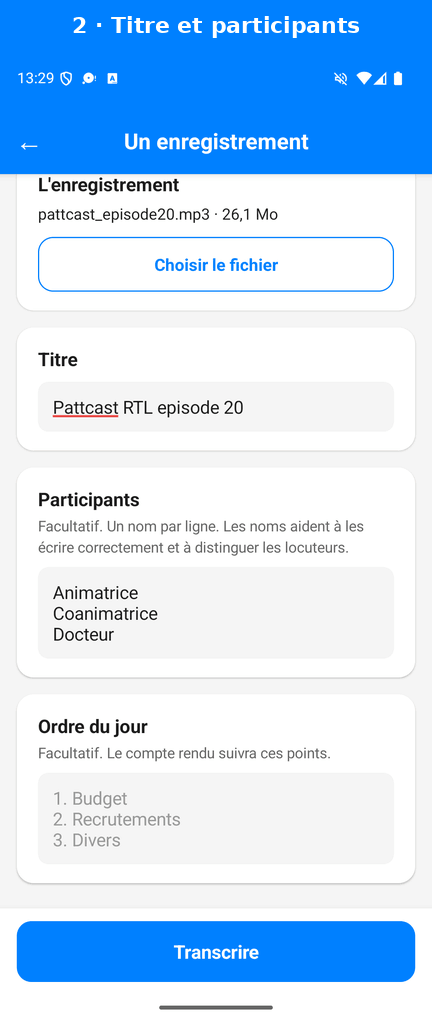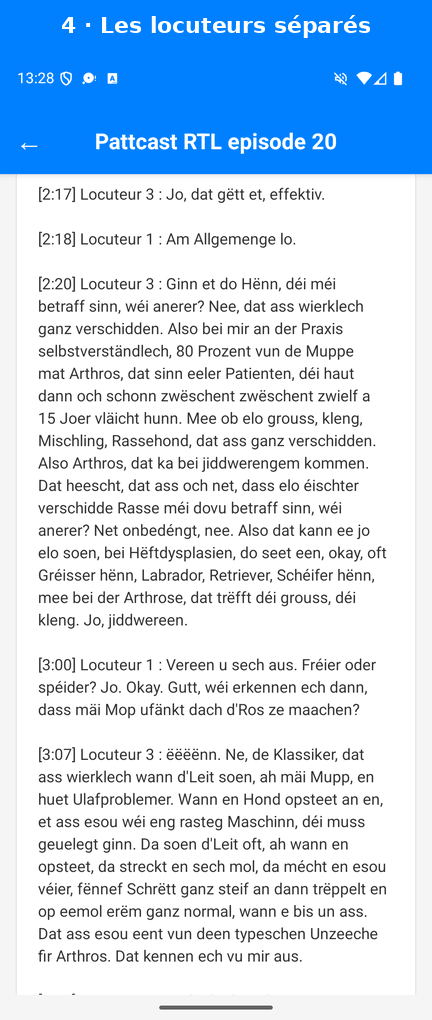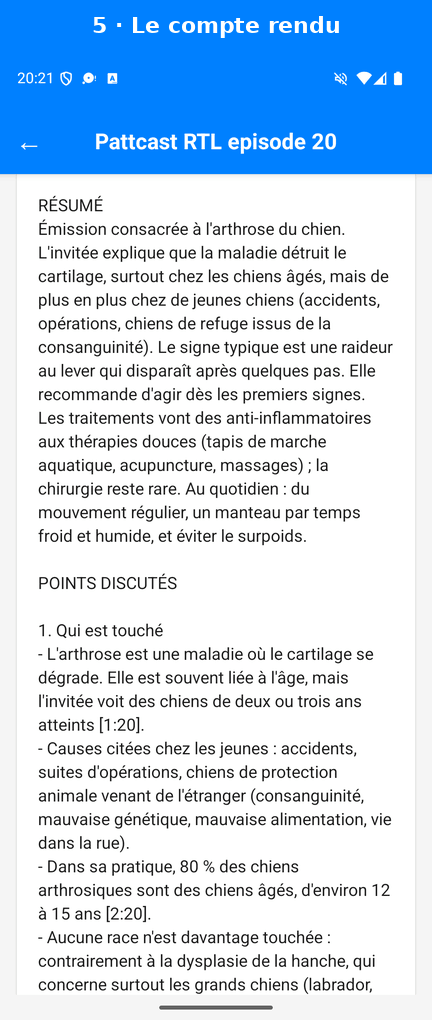
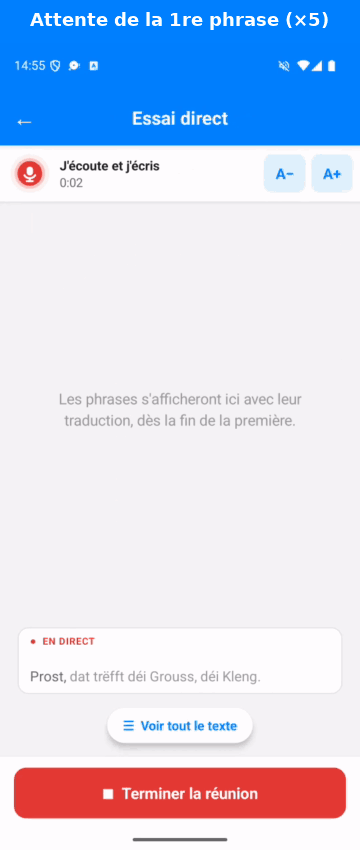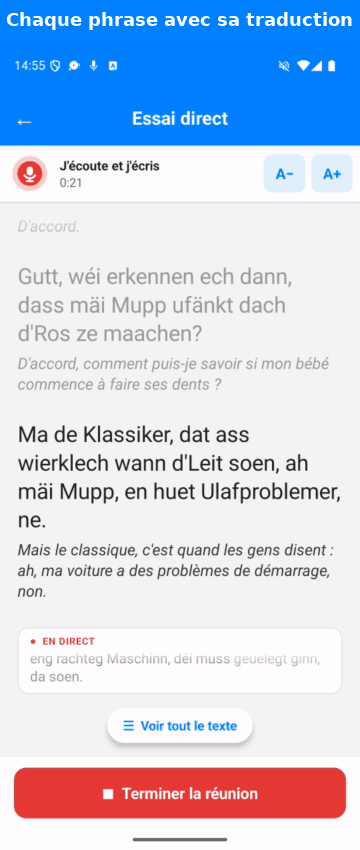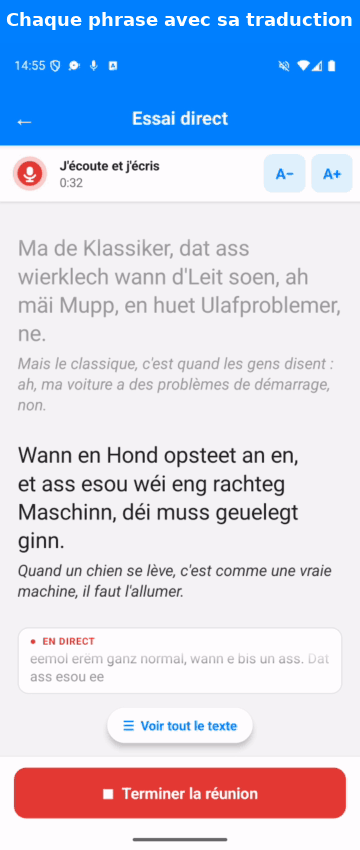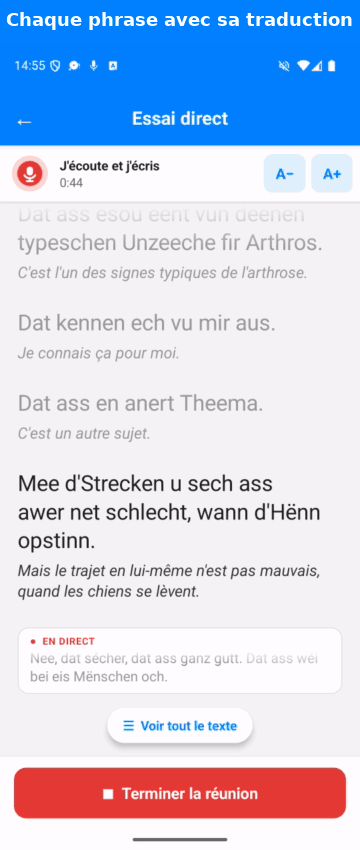
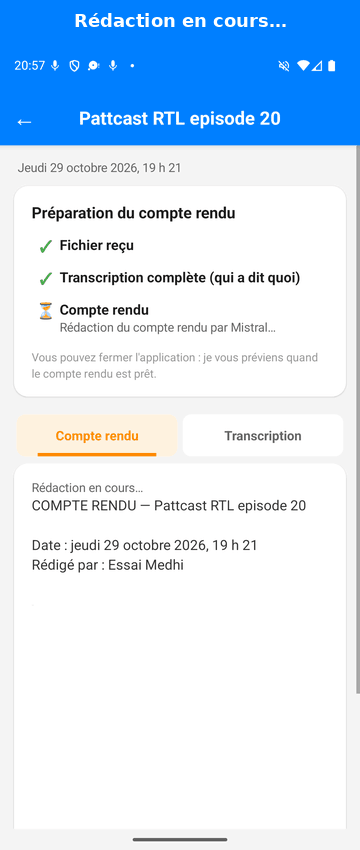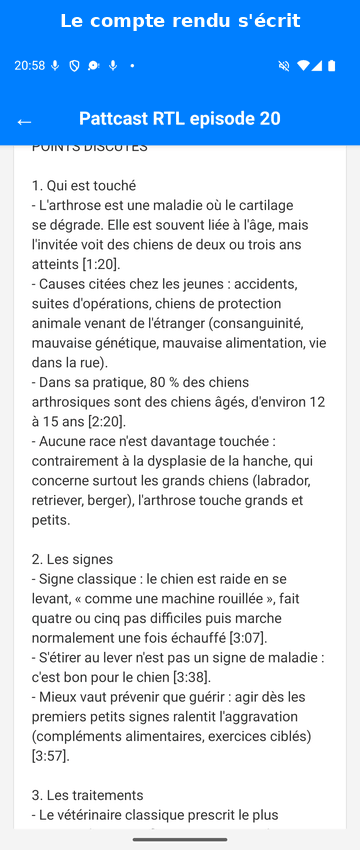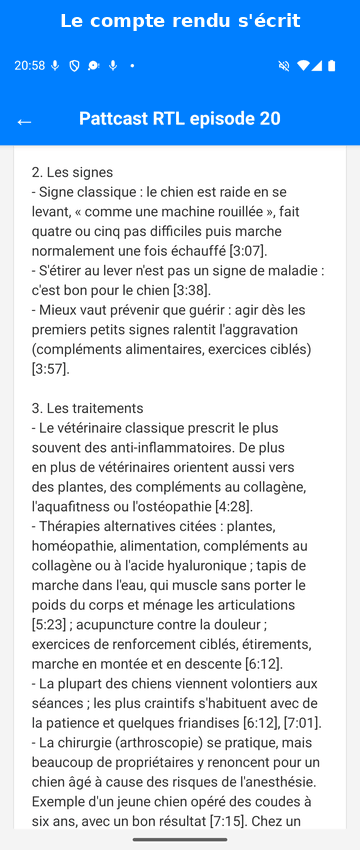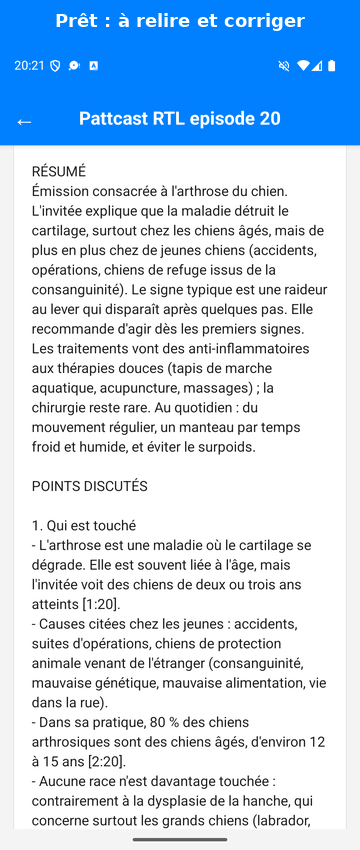
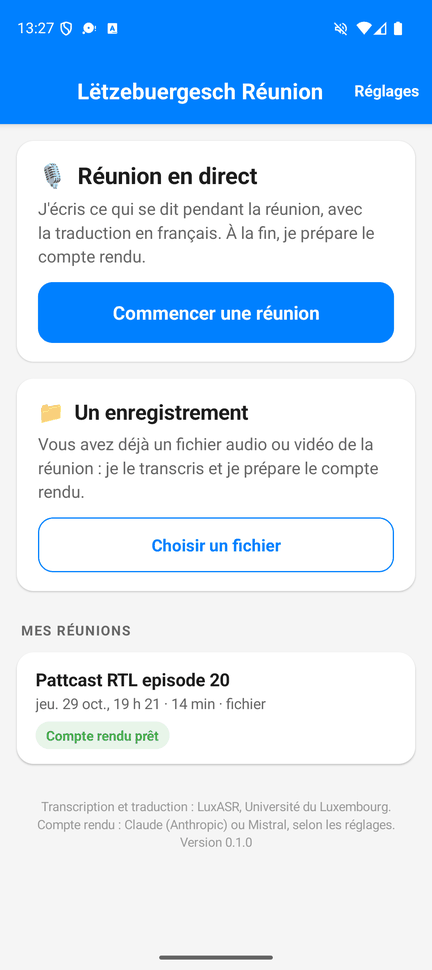
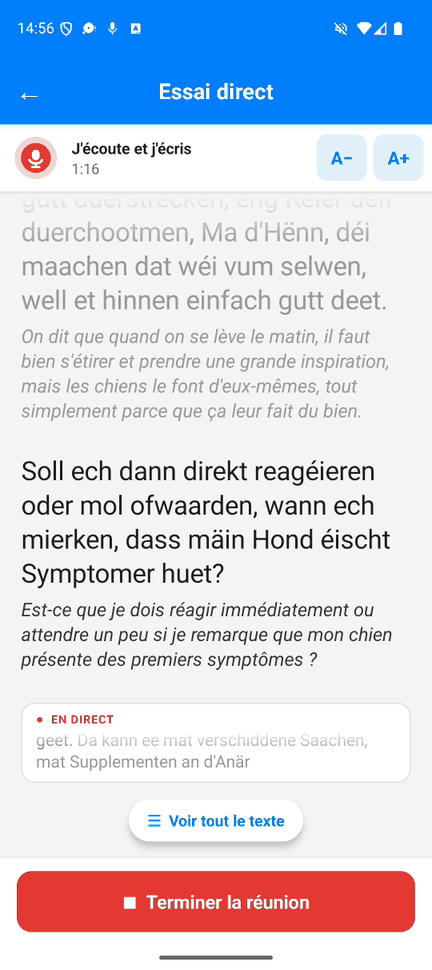
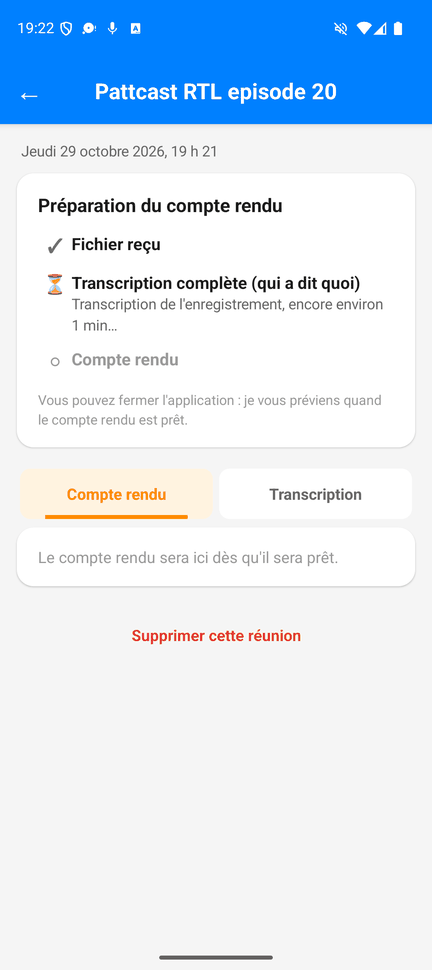
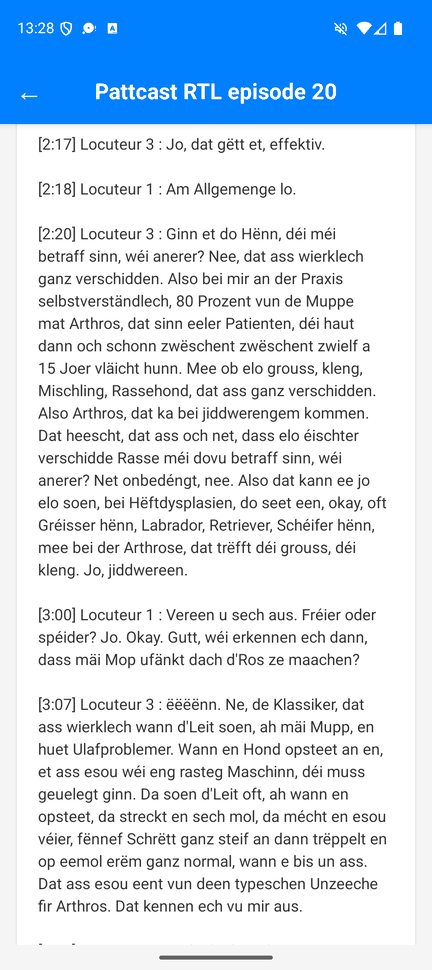
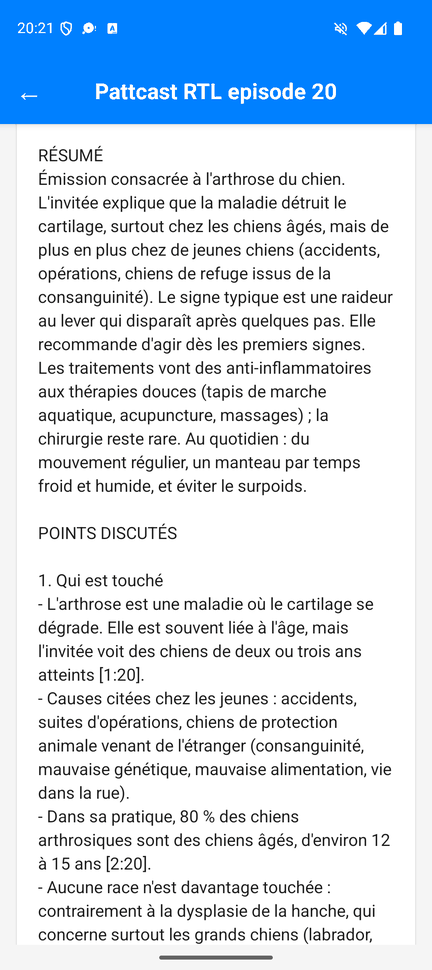
Ces images viennent d'un essai sur émulateur, le 29 octobre 2026, avec l'épisode 20 du podcast « Pattcast » de RTL Radio Lëtzebuerg (13 minutes, trois locutrices, © CLT-UFA) : la transcription est revenue en une minute environ, les trois locutrices séparées. Le compte rendu montré a été rédigé à la main, en suivant les consignes que l'application donne au service de rédaction, puis renvoyé à l'application par un faux service, faute de crédit sur les clés d'essai. Pour le direct, le micro de l'émulateur ne transmettant pas le son, l'épisode a été lu par l'application à la place du micro ; la liaison avec LuxASR et la traduction sont les vraies.
🔒 Le son part à LuxASR, à l'Université du Luxembourg ; le texte de la réunion part au service qui rédige le compte rendu (Claude, d'Anthropic, ou Mistral, au choix de qui installe l'application). Prévenez les participants que la réunion est enregistrée, et demandez l'accord de votre employeur.
Pour les curieux : comment ça marche
La page envoie le fichier tel quel à l'API par lots de LuxASR
(POST /asr2, avec diarization=Enabled et
outfmt=json), puis demande où en est le travail, d'abord
toutes les deux secondes puis de plus en plus rarement, et lit le
résultat, une seule fois : le service l'efface dès qu'il l'a servi. Le fichier va directement de votre navigateur au service : il ne
passe pas par ce site.
Le résultat est ramené à une liste de phrases (début, fin, locuteur, texte), coupées grâce à l'horodatage de chaque mot et à la taille d'un sous-titre. Les phrases consécutives d'une même voix forment un tour de parole ; c'est de cette liste que sont tirés les exports TXT, SRT, VTT et JSON. La réponse brute du service reste téléchargeable telle quelle.
En direct, la page parle au service comme la dictée du
clavier : une connexion WebSocket, le son en PCM 16 bits à 16 kHz au fil
de sa capture, et en retour le texte confirmé et la fin de phrase encore
instable. Pour qu'une longue écoute ne pèse pas sur le service, la
connexion est renouvelée environ toutes les deux minutes, pendant une
pause, sans couper le micro : ce qui est capté pendant le raccord part
juste après. Les horodatages des paragraphes sont approximatifs, à une
seconde près. La traduction est demandée au service dans la même
connexion (translation_enabled, cible fr) ; elle
revient phrase par phrase et se range sous le paragraphe de la phrase
traduite.
Pourquoi l'envoi peut échouer d'emblée. Une page web ne peut lire la réponse d'un autre site que si ce site l'y autorise, par un en-tête « CORS ». Relevé en septembre puis le 29 octobre 2026, le service ne le posait pas encore sur l'accusé de réception d'un envoi. La page le vérifie donc d'abord avec une demi-seconde de silence, pour ne pas faire travailler le service sur votre fichier en vain. Si c'est toujours le cas, la page vous le dit, sans réessayer à vide, et vous propose de transcrire sur luxasr.uni.lu puis d'ouvrir le résultat ici.
Dites-nous ce que ça donne
Labs sert à essayer avant de décider. Le plus utile à nous transmettre : le type d'enregistrement, sa durée, le nombre de voix, et ce qui a été bien ou mal séparé.